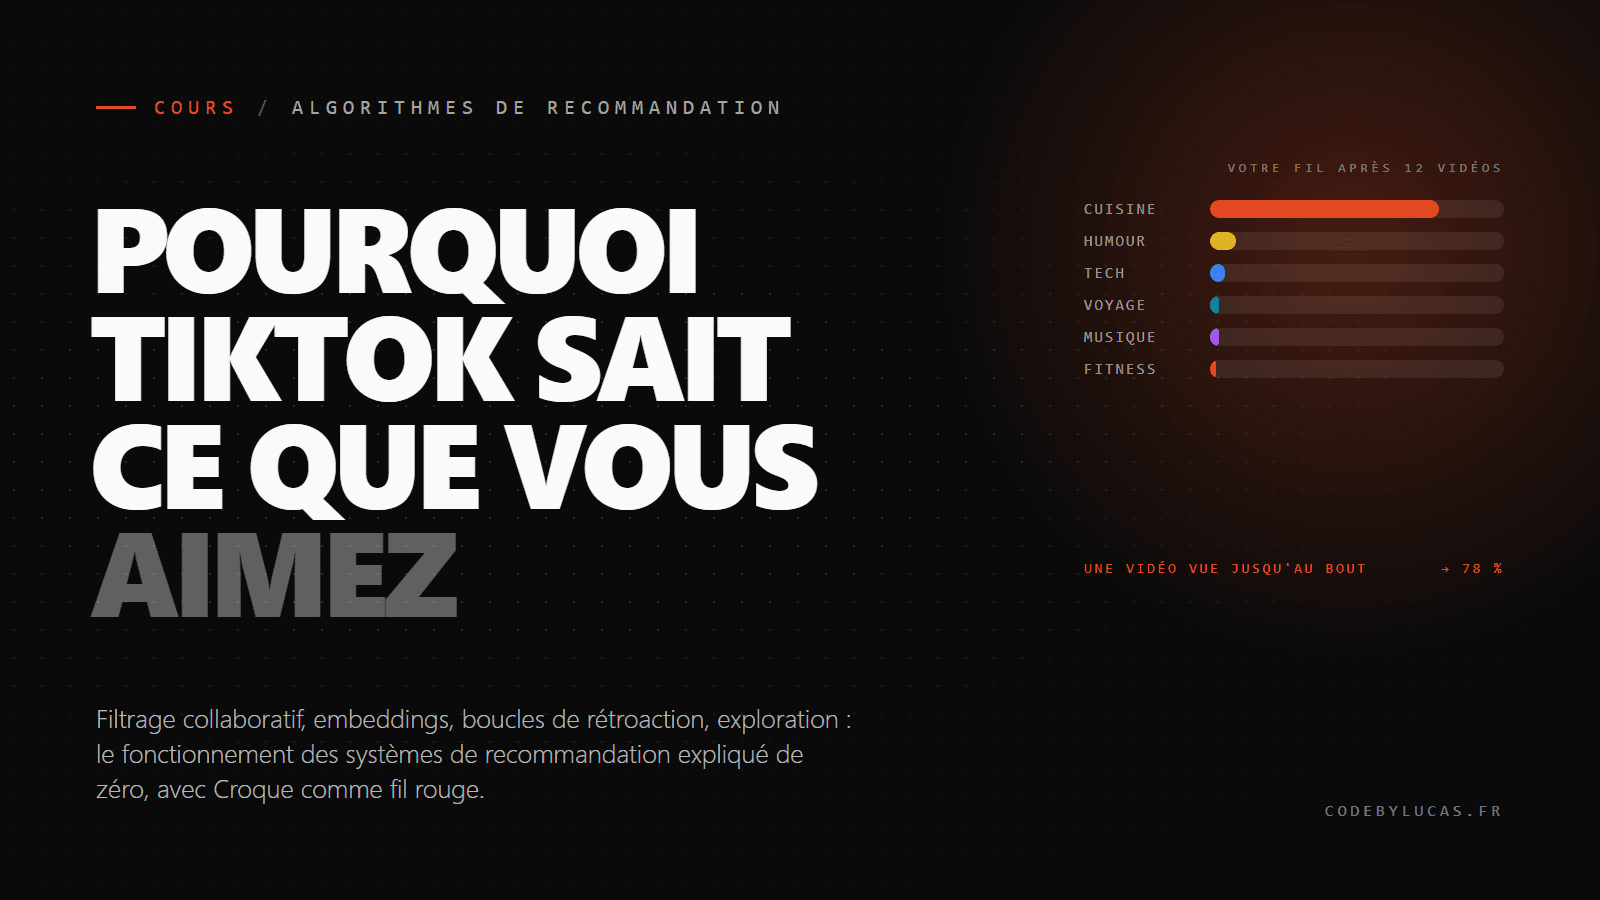
Vous ouvrez TikTok pour cinq minutes. Une vidéo de cuisine vous accroche, vous la regardez jusqu'au bout. Dix minutes plus tard, votre fil ne parle plus que de cuisine. Vous n'avez rien liké, rien cherché, rien dit. Comment l'application a-t-elle pu « comprendre » aussi vite ? Et pourquoi a-t-elle l'air de vous connaître mieux que vos amis ?
Ce phénomène n'a rien de magique. Il repose sur une famille d'algorithmes, les systèmes de recommandation, qui sont aujourd'hui le cœur économique de YouTube, Spotify, Netflix, Amazon, Tinder et TikTok. Ce sont eux qui décident, des milliards de fois par jour, ce que des milliards de personnes voient.
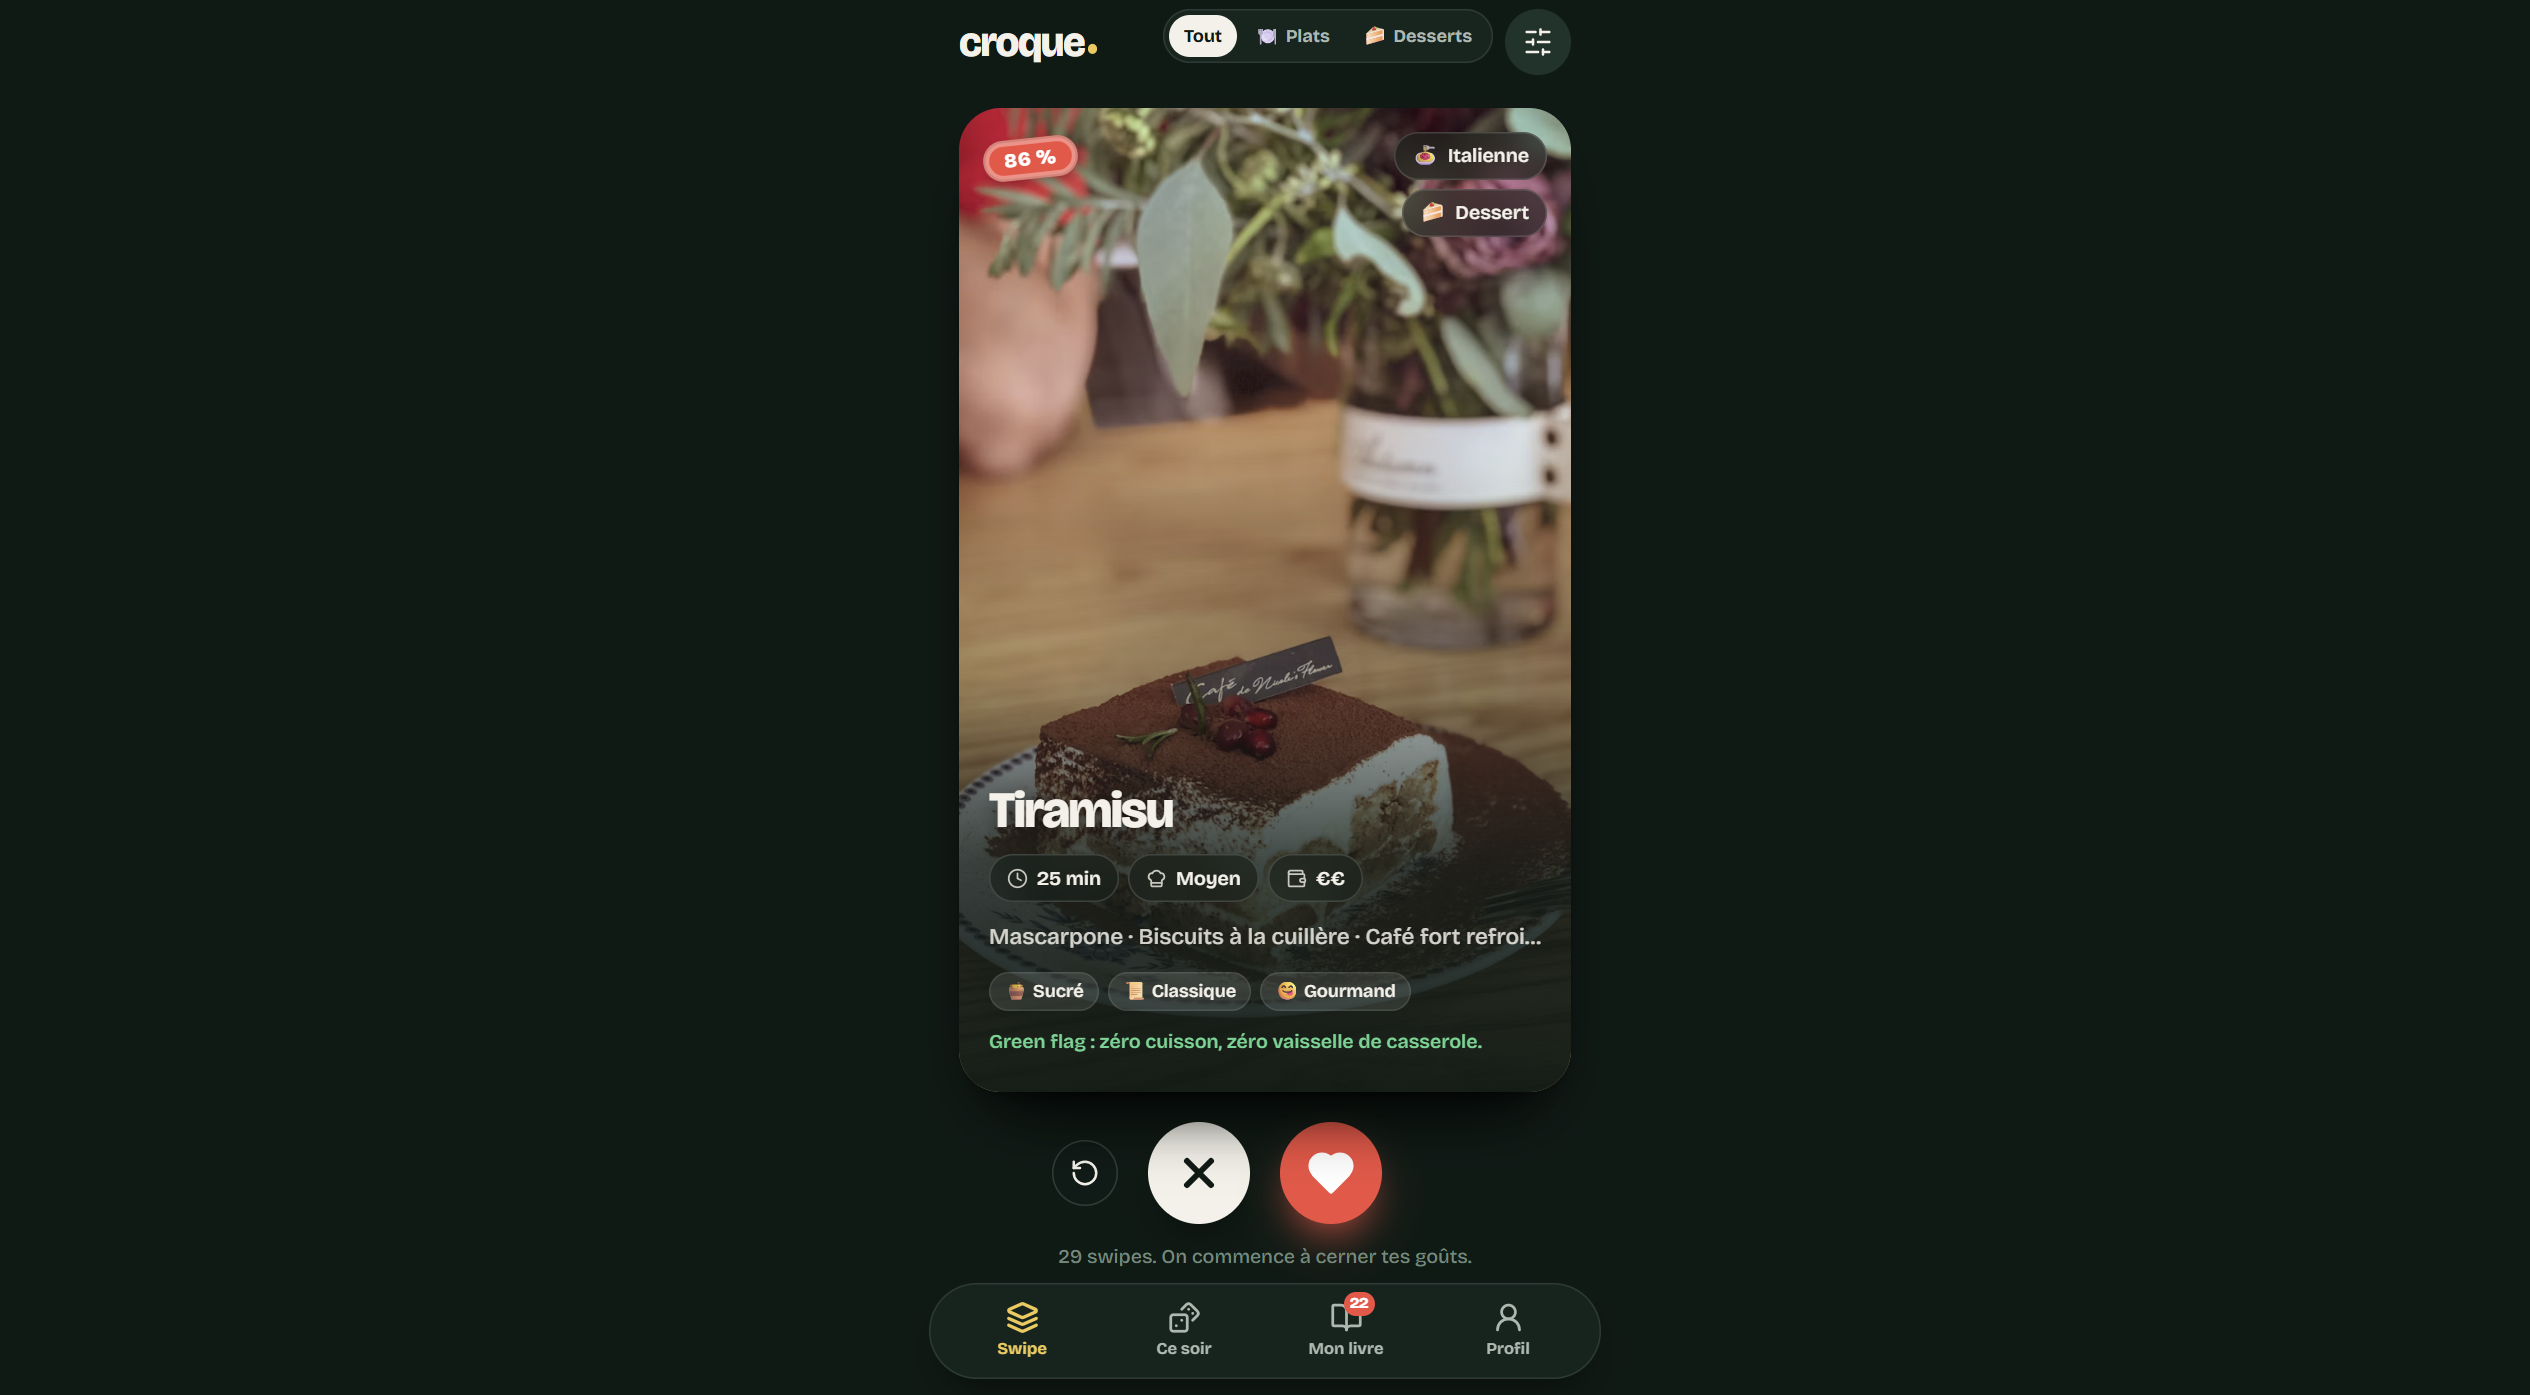
Cet article est un cours, écrit pour être lu sans aucun bagage technique. Nous allons remonter du geste le plus simple, un swipe, jusqu'aux architectures qui tournent chez les géants, en passant par les questions qui fâchent : bulles de filtre, radicalisation, biais de popularité. Pour rendre tout cela concret, je prendrai comme fil rouge Croque, une application que j'ai construite et qui applique les mécaniques de Tinder au choix d'un dîner : on swipe des recettes, l'app apprend les goûts, et un bouton répond à « je mange quoi ce soir ? ». Son moteur est volontairement simple et lisible, ce qui en fait un excellent support pour comprendre les grands.
Pas une ligne de code dans cet article. En revanche, des animations que vous pouvez manipuler, et des références vers les articles scientifiques qui ont fondé le domaine.
Le problème que résout un système de recommandation
Avant les recommandations, le web fonctionnait avec la recherche : vous tapiez un mot, on vous rendait une liste. Ça suppose que vous sachiez ce que vous voulez. Or, la plupart du temps, ce n'est pas le cas. Vous voulez « quelque chose de bien à regarder », « un morceau qui colle à l'ambiance », « un dîner qui ne prend pas une heure ». Vous ne savez pas formuler la requête, mais vous reconnaîtrez la bonne réponse quand elle passera.
Un système de recommandation est une machine à répondre à des envies non formulées. Netflix estimait en 2015 qu'environ 80 % des heures visionnées sur sa plateforme venaient de ses recommandations, contre 20 % de la recherche [1]. Chez YouTube, les ingénieurs décrivent leur système comme « l'un des plus grands et des plus sophistiqués au monde » [2]. Pour ces entreprises, l'algorithme n'est pas une fonctionnalité parmi d'autres : c'est le produit.
Le problème se décompose en trois questions, que tout le reste de l'article va détailler.
Croque se pose exactement ces trois questions, à petite échelle : avec un catalogue de 187 recettes sur 54 cuisines, comment savoir ce qu'une personne aime après dix swipes, quelle recette lui montrer ensuite, et quand glisser un plat éthiopien à quelqu'un qui n'a liké que de l'italien ?
Le vocabulaire minimum : signaux, features, score
Trois mots suffisent pour lire la suite.
Un signal est une trace que vous laissez. On distingue les signaux explicites, que vous donnez volontairement (une note, un like, un « pas intéressé »), et les signaux implicites, que vous laissez sans y penser : le temps passé sur une vidéo, le fait de la regarder jusqu'au bout ou de la passer après deux secondes, un morceau réécouté, un profil sur lequel on s'attarde. Les signaux implicites sont dix à cent fois plus nombreux que les explicites, et souvent plus honnêtes : on like parfois par politesse, on ne regarde jamais jusqu'au bout par politesse.
Une feature (une caractéristique) est une étiquette qui décrit un contenu : la cuisine d'une recette, le genre d'un morceau, la durée d'une vidéo, le sujet d'un post. Les features sont fournies par des humains (le tag « végétarien ») ou déduites automatiquement par d'autres modèles (le sujet d'une vidéo, reconnu depuis l'image et le son).
Un score est le nombre que le système attribue à un couple « vous et ce contenu ». Plus il est haut, plus le contenu remonte. Toute l'ingénierie consiste à calculer ce score de la façon la plus juste possible, à partir des signaux et des features.
Première famille : recommander par le contenu
La méthode la plus intuitive s'appelle le filtrage basé sur le contenu. Le raisonnement tient en une phrase : si vous avez aimé des choses qui ont telles caractéristiques, on vous propose d'autres choses qui ont les mêmes.
C'est exactement ce que fait Croque. Chaque recette est décomposée en une liste de features pondérées : la cuisine pèse le plus lourd, parce que c'est le facteur qui prédit le mieux un like ; viennent ensuite le type de plat, les tags (épicé, rapide, réconfort), la protéine, la durée et le coût.
| Feature | Exemple | Poids | |---|---|---| | Cuisine | italienne, japonaise, mexicaine | 3 | | Type de plat | végétarien, vegan | 2 | | Tag | épicé, rapide, réconfort | 1,4 | | Protéine | poulet, poisson, tofu | 1,2 | | Catégorie et durée | plat ou dessert, rapide ou long | 1 | | Difficulté et coût | facile, bon marché | 0,6 |
À chaque swipe, l'app met à jour une affinité pour chaque feature de la carte. Le calcul est volontairement simple : on compte les likes et les dislikes reçus par la feature, et l'affinité vaut le nombre de likes plus un, divisé par le nombre total de swipes plus deux. Cette petite astuce s'appelle le lissage de Laplace, et elle a une conséquence précieuse : une feature jamais vue vaut exactement 0,5, neutre, et une feature vue une seule fois ne bascule jamais à 0 ou à 1. Il faut plusieurs signaux concordants pour qu'une affinité devienne franchement haute ou basse. Le système ne sur-réagit pas à un swipe distrait.
Manipulez l'animation ci-dessous. Swipez quelques cartes, ou lancez le mode automatique, et observez les barres d'affinité se déplacer et le pourcentage de compatibilité de la carte suivante grimper.
Deux détails supplémentaires rendent le profil vivant. D'abord, les swipes récents pèsent plus que les anciens : les vingt derniers comptent plein pot, les plus vieux s'effacent doucement, jusqu'à un plancher, pour que le profil suive des goûts qui évoluent plutôt que de figer une première impression. Ensuite, Croque mélange ce que vous avez déclaré à l'inscription (les cuisines cochées, le budget) avec ce que vous faites réellement, selon une confiance qui grandit avec le nombre de swipes : au début l'app s'appuie sur vos déclarations, après une quinzaine de swipes votre comportement prend le dessus, jusqu'à 65 % du poids mais jamais 100 %. Les allergies, elles, excluent en dur, quoi qu'il arrive.
Spotify utilise la même idée à une autre échelle. Chaque morceau est décrit par des dizaines de features audio calculées automatiquement (tempo, énergie, « dansabilité », acoustique) et par des features textuelles extraites de ce que le web dit du morceau. Votre profil est une moyenne pondérée des morceaux que vous écoutez [5].
Deuxième famille : recommander par les gens qui vous ressemblent
Le filtrage collaboratif part d'une intuition différente : on n'a pas besoin de comprendre le contenu. Il suffit de trouver des gens qui aiment ce que vous aimez, et de regarder ce qu'ils aiment d'autre.
C'est l'idée derrière le célèbre « les clients qui ont acheté cet article ont aussi acheté ». Amazon l'a industrialisée au début des années 2000 avec une variante astucieuse : plutôt que de comparer des clients entre eux, ce qui coûte trop cher quand on en a des dizaines de millions, on précalcule pour chaque article la liste des articles qui sont souvent achetés avec lui [6, 7]. Le contenu des articles n'entre jamais en jeu : le système ne sait pas qu'un livre parle de cuisine, il sait juste que les gens qui l'achètent achètent aussi tel couteau.
L'animation ci-dessous montre le mécanisme sur un exemple minuscule. Le système ne connaît rien des films. Il cherche seulement la ligne qui ressemble le plus à la vôtre.
En 2006, Netflix a lancé un concours doté d'un million de dollars pour améliorer ses recommandations de 10 %. La technique gagnante, la factorisation de matrices, a marqué le domaine [8]. L'idée : imaginer que chaque personne et chaque film sont décrits par une poignée de nombres cachés, disons une vingtaine, que personne n'a définis à l'avance. La machine ajuste ces nombres jusqu'à ce que leur combinaison reproduise le mieux possible les notes connues. Une fois trouvés, ils servent à prédire les notes inconnues. Ce qui est fascinant, c'est qu'en regardant ces nombres après coup, on retrouve souvent des dimensions humainement lisibles : « film pour adultes ou pour enfants », « grand public ou d'auteur », « comédie ou drame ». Personne ne les a programmées ; elles ont émergé des données.
Les embeddings : tout représenter dans le même espace
Les deux familles précédentes ont convergé, dans les années 2010, vers une représentation commune : l'embedding. Le mot fait peur, l'idée est simple. Un embedding, c'est un point dans un espace. Chaque morceau, chaque vidéo, chaque recette, chaque utilisateur devient un point. Deux points proches signifient « ces deux choses vont ensemble ».
D'où viennent les coordonnées ? Des données de co-occurrence. La technique la plus connue vient du traitement du langage : word2vec apprend qu'un mot est défini par les mots qui l'entourent [9]. Spotify a appliqué exactement le même raisonnement aux playlists : une playlist est une « phrase », les morceaux sont ses « mots », et deux morceaux qui apparaissent souvent dans les mêmes playlists finissent proches dans l'espace [5]. C'est ainsi que Discover Weekly peut vous proposer un morceau que vous n'avez jamais entendu, d'un artiste que vous ne connaissez pas : il est voisin, dans l'espace, de ce que vous écoutez.
Chez YouTube, les embeddings sont produits par des réseaux de neurones. L'architecture la plus répandue s'appelle two-tower, deux tours : un réseau transforme l'utilisateur (son historique, son contexte, son appareil) en un point, un autre transforme chaque vidéo en un point, et recommander revient à chercher les points de vidéos les plus proches du point de l'utilisateur [2, 10]. Les vraies applications utilisent des centaines de dimensions, pas deux, mais l'animation ci-dessus est fidèle au principe.
Le moteur de Croque n'apprend pas d'embeddings : il n'a ni assez d'utilisateurs, ni assez de signaux pour cela. J'ai fait le choix d'un système de règles calibré à la main, lisible et déboguable, en isolant le moteur dans un module qui ne dépend d'aucune interface, précisément pour qu'un modèle appris puisse le remplacer plus tard sans rien réécrire d'autre.
Le pipeline industriel : trier des milliards de contenus en quelques millisecondes
Une chose que les explications grand public passent sous silence : un système comme celui de YouTube ne calcule pas un score pour chacune des milliards de vidéos à chaque ouverture de l'application. C'est physiquement impossible dans le temps imparti. Il travaille en étages.
Le premier étage, la génération de candidats, doit être très rapide et très grossier. Il utilise des méthodes légères, souvent une recherche de voisins dans l'espace des embeddings, pour ramener le catalogue à quelques centaines de contenus plausibles. Le deuxième étage, le classement, peut se permettre un modèle beaucoup plus lourd, puisqu'il ne traite que ces quelques centaines : il prédit, pour chaque candidat, plusieurs choses à la fois, par exemple la probabilité que vous cliquiez, le temps que vous passerez, la probabilité que vous partagiez ou que vous signaliez « pas intéressé » [11]. Le troisième étage, le reclassement, applique des règles qui ne sont pas de la prédiction : ne pas montrer trois vidéos du même créateur d'affilée, privilégier les contenus récents, respecter les contraintes légales.
C'est la même architecture que j'ai mise en place dans mon travail chez SensCritique, sur un catalogue de 785 000 œuvres et 109 millions d'interactions : un étage de retrieval qui combine filtrage collaboratif et recherche vectorielle, puis un étage de reranking par un modèle de gradient boosting. Le passage à cette architecture a doublé la pertinence des suggestions et multiplié par dix-neuf la diversité des œuvres recommandées.
Pourquoi une seule vidéo change tout : la boucle de rétroaction
Revenons à la question de départ. Vous regardez une vidéo de cuisine jusqu'au bout, et votre fil bascule. Voici, étape par étape, ce qui se passe.
Le temps de visionnage complet est un signal implicite fort. Le système met à jour votre profil : votre point dans l'espace se déplace vers la région « cuisine ». Le prochain lot de candidats est tiré autour de votre nouveau point : il contient plus de cuisine. Le fil suivant vous montre donc plus de cuisine. Et ici intervient un effet que l'on oublie toujours : vous regardez plus de cuisine parce qu'on vous en montre plus, pas seulement parce que vous l'aimez. Le système lit ce visionnage supplémentaire comme une confirmation, déplace encore votre point, et la boucle se referme.
Ce mécanisme porte un nom dans la littérature scientifique : la boucle de rétroaction. Une équipe de Princeton a montré par simulation que quand un système apprend à partir de données qui ont elles-mêmes été produites par ses propres recommandations, les goûts observés deviennent de plus en plus homogènes et la qualité réelle des recommandations baisse, tout en donnant l'impression de monter : le système se félicite de prédire des comportements qu'il a lui-même provoqués [12]. Des chercheurs de DeepMind ont formalisé le cas extrême, la « boucle dégénérée », où le système finit par ne plus proposer qu'une région minuscule du catalogue [13].
Trois ingrédients aggravent la boucle. Le premier est la vitesse : TikTok recalcule votre fil quasiment à chaque vidéo, là où Netflix le faisait autrefois une fois par jour ; plus le cycle est court, plus la boucle converge vite. Le deuxième est le poids des signaux implicites : un temps de visionnage ne demande aucune décision consciente, donc le système apprend même quand vous n'avez rien voulu dire. Le troisième est le biais de popularité : les contenus déjà populaires ont plus de signaux, donc de meilleures prédictions, donc plus d'exposition, donc plus de signaux ; les contenus de niche et les nouveaux créateurs partent avec un handicap structurel [14].
Exploiter ou explorer : pourquoi les bons systèmes prennent des risques
Si la boucle de rétroaction est le poison, l'antidote a un nom : l'exploration. Un système qui ne montre que ce qu'il est sûr que vous aimerez (on dit qu'il exploite ses connaissances) ne peut jamais apprendre que vous aimeriez autre chose. Il doit, une partie du temps, vous montrer des contenus dont il n'est pas sûr, quitte à se tromper.
Ce dilemme est étudié depuis les années 1950 sous le nom de problème du bandit manchot : face à plusieurs machines à sous aux gains inconnus, comment répartir ses pièces entre celle qui a l'air de payer le mieux et celles qu'on n'a pas encore essayées ? La stratégie la plus simple, dite epsilon-greedy, consiste à jouer le meilleur bras connu la plupart du temps et un bras au hasard une petite fraction du temps. Manipulez le curseur ci-dessous : à zéro, l'algorithme se verrouille sur le premier bras correct et ne découvre jamais le meilleur.
Les grandes plateformes utilisent des versions sophistiquées de ce principe. Yahoo a été l'un des premiers à publier l'usage de bandits contextuels pour choisir les articles de sa page d'accueil [15]. Spotify a expliqué comment il combine exploration et explications (« parce que vous avez écouté... ») pour tester des recommandations plus risquées sans perdre la confiance de l'auditeur [16]. Netflix a formalisé la notion de recommandations calibrées : si vous regardez 70 % de comédies et 30 % de documentaires, votre page doit refléter ces proportions, plutôt que de ne montrer que des comédies parce qu'elles ont chacune un score légèrement plus haut [17].
Croque applique trois mécanismes de ce genre, minuscules mais décisifs. Un peu de bruit aléatoire est ajouté à chaque reclassement, pour que deux sessions ne montrent jamais exactement le même ordre à score égal. Une pénalité de diversité fait perdre des points à une recette dont la cuisine vient d'être montrée deux fois de suite, pour éviter cinq plats italiens d'affilée. Et une carte sur quatre est tirée non pas en tête du classement, mais au hasard dans le milieu du peloton : c'est cette carte-là qui permet de découvrir que quelqu'un qui n'a liké que des pâtes adore, en fait, le dahl de lentilles.
Tinder et le match : quand la recommandation doit être réciproque
Les apps de rencontre posent une variante du problème que YouTube n'a pas : la recommandation doit marcher dans les deux sens. Il ne sert à rien de vous montrer un profil qui vous plaira si vous ne lui plairez pas. On parle de marché à deux faces, ou de recommandation réciproque.
Tinder a longtemps utilisé, pour ordonner les profils, un score inspiré du classement Elo des échecs : chaque like reçu d'un profil très liké comptait plus qu'un like d'un profil peu liké, et le système tendait à montrer des profils de « niveau » comparable. L'entreprise a annoncé en 2019 avoir abandonné ce système au profit d'un classement fondé sur l'activité récente et les interactions [18]. Elle reste discrète sur le détail, mais les principes de cet article s'appliquent : signaux implicites (le temps passé sur un profil), embeddings de profils, exploration pour ne pas enfermer les nouveaux inscrits.
Croque emprunte à Tinder son moment le plus fort, le match, et m'a appris quelque chose sur sa mécanique. Dans l'app, un like sur une recette dont la compatibilité affichée dépasse 90 % déclenche un écran plein écran avec confettis. Le premier réglage était à 85 %. Résultat : après une quinzaine de swipes, presque chaque like déclenchait un match, et le moment ne produisait plus aucun effet. Remonter le seuil à 90 % a redonné au match sa rareté relative, condition de son impact émotionnel. Une recommandation n'est pas seulement un score : c'est aussi une mise en scène, et la rareté fait partie de la mise en scène.
Les enjeux : bulles, radicalisation, biais, et ce que dit la science
Il serait facile de conclure que les algorithmes de recommandation nous enferment. La réalité, telle que la décrit la recherche, est plus nuancée, et donc plus intéressante.
La notion de bulle de filtre a été popularisée en 2011 par Eli Pariser [19]. La première étude empirique d'envergure, menée sur des données de MovieLens, a trouvé un effet réel mais modeste : les personnes qui suivaient les recommandations voyaient effectivement leur consommation se resserrer légèrement au fil du temps, mais elles étaient aussi, en moyenne, plus satisfaites de ce qu'elles regardaient [20]. Autrement dit, le resserrement existe, et il n'est pas vécu comme un enfermement.
La question de la radicalisation sur YouTube a fait l'objet d'études contradictoires. Une analyse de 2020 portant sur des millions de commentaires a montré une migration réelle d'audiences de chaînes modérées vers des chaînes plus extrêmes au fil du temps [21]. Mais une étude de 2021 publiée dans PNAS, fondée sur l'historique de navigation réel de plus de 300 000 Américains, conclut que la consommation de contenus extrêmes est concentrée sur une petite minorité qui y arrive surtout par des liens externes, et non par la recommandation [22]. Les deux résultats ne sont pas incompatibles : l'algorithme n'est pas la cause unique, mais il peut être un accélérateur pour ceux qui ont déjà mis un pied dans la porte.
Le biais de popularité est mieux établi. Des travaux ont montré que les systèmes collaboratifs classiques amplifient les contenus déjà populaires et servent moins bien certains groupes d'utilisateurs, simplement parce qu'ils ont moins de données à leur sujet [14]. Ce n'est pas une intention, c'est une conséquence mécanique de l'apprentissage sur des données déséquilibrées.
Enfin, la question est devenue réglementaire. Depuis 2023, le règlement européen sur les services numériques impose aux très grandes plateformes de proposer au moins une version de leur fil qui ne repose pas sur le profilage, et de documenter les principaux paramètres de leurs systèmes de recommandation [23]. TikTok, Instagram et YouTube proposent désormais cette option en Europe.
Reprendre la main, des deux côtés de l'écran
Pour l'utilisateur, tout découle du fonctionnement décrit plus haut. Le système apprend surtout de vos signaux implicites : le geste le plus puissant pour corriger un fil n'est donc pas le like, mais le temps. Passer vite ce que vous ne voulez plus voir pèse plus qu'un long soupir devant l'écran. Les boutons « pas intéressé » sont des signaux explicites forts, souvent traités avec un poids élevé. Regarder délibérément des sujets variés déplace votre point dans l'espace, exactement comme dans l'animation de la boucle de rétroaction. Et l'option « fil non personnalisé » existe désormais, si vous voulez voir ce que l'algorithme vous cache.
Pour celui qui conçoit un système, Croque m'a convaincu de quelques principes. Garder des préférences explicites qui ont toujours une voix, pour qu'une mauvaise journée de swipes distraits ne réécrive pas tout le profil. Réserver une part fixe du fil à l'exploration, et la considérer comme une fonctionnalité, pas comme un coût. Rendre les recommandations explicables : Croque affiche pour chaque recette des « red flags » et des « green flags » générés selon votre profil (« Red flag : 47 minutes de préparation », « Green flag : ça pique, comme tu aimes »), et cette transparence change la relation à la recommandation, qui devient une proposition argumentée plutôt qu'un oracle. Et choisir avec soin la métrique que l'on optimise, parce que c'est elle, in fine, qui dessine le comportement du produit.
Pour aller plus loin
Les références ci-dessous sont celles qui ont fondé les idées de cet article. La plupart sont accessibles gratuitement.
- Gomez-Uribe, C. A., Hunt, N. (2015). The Netflix Recommender System: Algorithms, Business Value, and Innovation. ACM Transactions on Management Information Systems, 6(4). dl.acm.org/doi/10.1145/2843948
- Covington, P., Adams, J., Sargin, E. (2016). Deep Neural Networks for YouTube Recommendations. Proceedings of RecSys 2016. research.google/pubs/pub45530
- TikTok Newsroom (2020). How TikTok recommends videos #ForYou. newsroom.tiktok.com
- The Wall Street Journal (2021). Inside TikTok's Algorithm: A WSJ Video Investigation. wsj.com
- Jacobson, K., Murali, V., Newett, E., Whitman, B., Yon, R. (2016). Music Personalization at Spotify. Proceedings of RecSys 2016. dl.acm.org/doi/10.1145/2959100.2959120
- Sarwar, B., Karypis, G., Konstan, J., Riedl, J. (2001). Item-based collaborative filtering recommendation algorithms. Proceedings of WWW 2001. dl.acm.org/doi/10.1145/371920.372071
- Linden, G., Smith, B., York, J. (2003). Amazon.com Recommendations: Item-to-Item Collaborative Filtering. IEEE Internet Computing, 7(1). ieeexplore.ieee.org/document/1167344
- Koren, Y., Bell, R., Volinsky, C. (2009). Matrix Factorization Techniques for Recommender Systems. IEEE Computer, 42(8). ieeexplore.ieee.org/document/5197422
- Mikolov, T., Chen, K., Corrado, G., Dean, J. (2013). Efficient Estimation of Word Representations in Vector Space. arxiv.org/abs/1301.3781
- Yi, X. et al. (2019). Sampling-Bias-Corrected Neural Modeling for Large Corpus Item Recommendations. Proceedings of RecSys 2019. research.google/pubs/pub48840
- Zhao, Z. et al. (2019). Recommending What Video to Watch Next: A Multitask Ranking System. Proceedings of RecSys 2019. dl.acm.org/doi/10.1145/3298689.3346997
- Chaney, A. J. B., Stewart, B. M., Engelhardt, B. E. (2018). How Algorithmic Confounding in Recommendation Systems Increases Homogeneity and Decreases Utility. Proceedings of RecSys 2018. arxiv.org/abs/1710.11214
- Jiang, R., Chiappa, S., Lattimore, T., György, A., Kohli, P. (2019). Degenerate Feedback Loops in Recommender Systems. Proceedings of AIES 2019. arxiv.org/abs/1902.10730
- Ekstrand, M. D. et al. (2018). All The Cool Kids, How Do They Fit In?: Popularity and Demographic Biases in Recommender Evaluation and Effectiveness. Proceedings of FAT* 2018. proceedings.mlr.press/v81/ekstrand18b.html
- Li, L., Chu, W., Langford, J., Schapire, R. E. (2010). A Contextual-Bandit Approach to Personalized News Article Recommendation. Proceedings of WWW 2010. arxiv.org/abs/1003.0146
- McInerney, J. et al. (2018). Explore, Exploit, and Explain: Personalizing Explainable Recommendations with Bandits. Proceedings of RecSys 2018. dl.acm.org/doi/10.1145/3240323.3240354
- Steck, H. (2018). Calibrated Recommendations. Proceedings of RecSys 2018. dl.acm.org/doi/10.1145/3240323.3240372
- Tinder (2019). Powering Tinder: The Method Behind Our Matching. tinder.com/blog
- Pariser, E. (2011). The Filter Bubble: What the Internet Is Hiding from You. Penguin Press.
- Nguyen, T. T., Hui, P.-M., Harper, F. M., Terveen, L., Konstan, J. A. (2014). Exploring the Filter Bubble: The Effect of Using Recommender Systems on Content Diversity. Proceedings of WWW 2014. dl.acm.org/doi/10.1145/2566486.2568012
- Ribeiro, M. H., Ottoni, R., West, R., Almeida, V. A. F., Meira, W. (2020). Auditing Radicalization Pathways on YouTube. Proceedings of FAT* 2020. arxiv.org/abs/1908.08313
- Hosseinmardi, H. et al. (2021). Examining the consumption of radical content on YouTube. PNAS, 118(32). pnas.org/doi/10.1073/pnas.2101967118
- Règlement (UE) 2022/2065 relatif à un marché unique des services numériques (Digital Services Act), articles 27 et 38. eur-lex.europa.eu
Le code de Croque est ouvert : github.com/Lucas-lux/croque, et l'application se teste en ligne sur croque-zeta.vercel.app. Le moteur de recommandation décrit ici tient dans un dossier de fonctions pures, sans dépendance à l'interface, si vous voulez voir concrètement à quoi ressemblent ces règles une fois écrites.